Nueva Delhi, India ::: 29 de septiembre de 2026 ::: Para el hindi y el inglés, el mundo digital no es un terreno desconocido. La inteligencia artificial (IA) puede
reconocer ambos idiomas, procesar consultas y generar textos en ellos, en parte, porque dispone de grandes cantidades de datos digitales.
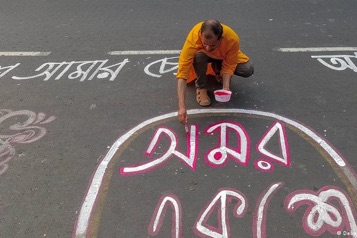
Sin embargo, la situación es diferente cuando la inteligencia artificial debe trabajar con otras lenguas menos habladas del país y sin conexión estable a Internet.
La India se ha propuesto mejorar la situación de los idiomas minoritarios en el ámbito digital. La iniciativa estatal BHASHINI presentó a mediados de septiembre, junto con sus socios, las conclusiones de un concurso de innovación para las denominadas aplicaciones de "Edge-AI".
Se trata de una IA multilingüe que pueda ejecutarse, en la medida de lo posible, directamente en los dispositivos. Entre otras cosas, se presentaron aplicaciones para la agricultura, la asistencia sanitaria, las prestaciones sociales y el asesoramiento jurídico.
¿Qué idiomas se tienen en cuenta?
Sin embargo, aparte de la cuestión técnica, también es necesario plantearse interrogantes más fundamentales: ¿cuáles de los numerosos idiomas de la India deben tenerse en cuenta? ¿Y qué ocurre con aquellos para los que apenas hay datos?
Un estudio publicado en 2024, que recopila 84 trabajos de investigación sobre la IA generativa y los grandes modelos de lenguaje para las lenguas indias, señala la falta de datos, la falta de estandarización, la diversidad lingüística y la insuficiencia de los métodos de evaluación como retos fundamentales.
Julius Haas, ingeniero eléctrico y experto en inteligencia artificial, destaca la desigualdad en la base de datos. En comparación con el inglés o el alemán, el corpus de textos es considerablemente más reducido: "Esto vale tanto para la cantidad como para la calidad", dice Haas, quien vive parcialmente en la India, en entrevista con DW.
Además, agrega, los dialectos locales plantean retos especiales: incluso las diferencias en la ortografía o la entonación pueden ser relevantes.
Lenguas en peligro de extinción
En el caso de las lenguas más pequeñas, las limitaciones son aún más evidentes. "Cuando una lengua apenas está documentada y existe muy poco material escrito, no hay datos suficientes con los que entrenar un modelo", explica a DW la sociolingüista Ariba Hidayet Khan, profesora de la Universidad de Kiel. De ahí que la IA solo pueda ayudar de forma limitada a este tipo de lenguas en la actualidad.
La situación es diferente en el caso de las lenguas en peligro de extinción que aún se hablan y de las que existe material disponible. Las ofertas digitales podrían suponer un aliciente para las generaciones más jóvenes para seguir aprendiendo su propia lengua. "Si utilizamos la IA ahora, podría contribuir a preservar la lengua durante más tiempo", cree Khan.
No obstante, si faltan documentación y hablantes, ni siquiera una IA puede revivir una lengua.
"Una cuestión de inversión"
Por este motivo, la India está tratando de crear la base de datos necesaria. Un actor importante es AI4Bharat, un instituto de investigación adscrito al Instituto Indio de Tecnología de Madrás. Desarrolla conjuntos de datos y modelos para la traducción, el reconocimiento de voz, la síntesis de voz y los grandes modelos lingüísticos. Sin embargo, los datos disponibles varían considerablemente de un idioma a otro.
"En el fondo, se trata sobre todo de una cuestión de inversión", señala Julian Haas. "Ya no se necesitan avances tecnológicos fundamentales", apunta el experto, y agrega que lo decisivo es a dónde se destinan los fondos de investigación y los recursos para la formación y la infraestructura.
Según el Informe sobre el estado de la educación en la India 2025, de la UNESCO, la lengua está estrechamente vinculada al aprendizaje, la identidad y la pertenencia cultural. Por ello, la UNESCO aboga por tecnologías digitales inclusivas que fomenten la educación multilingüe. La diversidad lingüística debe reflejarse también en el espacio digital.
Posibles nuevas jerarquías
Sin embargo, la digitalización también puede crear jerarquías completamente nuevas. Y es que una IA no refleja automáticamente toda la diversidad de una lengua. Si para un modelo se dispone principalmente de datos de una variante concreta ya consolidada, esta puede convertirse en el estándar digital. En este caso, otros dialectos y variantes regionales pueden seguir perdiendo visibilidad.
"Ya hoy en día vemos que la IA funciona mejor, por ejemplo, con el inglés estadounidense que con otras variedades del inglés", afirma Ariba Hidayet Khan. Para la India, esto supone un peligro especial: "La IA podría reforzar las jerarquías lingüísticas existentes", aclara la académica.
A su juicio, la participación de las distintas comunidades lingüísticas en el proceso de recopilación de datos es fundamental. Khan está convencida de que las personas no solo deberían aportar datos, sino también influir en el uso que se les da.
Un arma de doble filo
Otro reto es la infraestructura técnica. Cuando los modelos lingüísticos sean lo suficientemente pequeños, podrán ejecutarse directamente en un smartphone u otro dispositivo. Para las regiones con una conexión a Internet débil, esto podría ser decisivo. "Técnicamente es factible", dice Julius Haas.
La IA puede facilitar traducciones, materiales didácticos y nuevas formas de acceder a la información. Pero también puede reproducir o incluso afianzar las diferencias existentes. Y es que la diversidad lingüística en el espacio digital no surge únicamente de la tecnología adecuada, sino también de las decisiones sobre qué datos se recopilan y quién dispone de ellos.
::: ¿Qué idiomas se tienen en cuenta?
Sin embargo, aparte de la cuestión técnica, también es necesario plantearse interrogantes más fundamentales: ¿cuáles de los numerosos idiomas de la India deben tenerse en cuenta? ¿Y qué ocurre con aquellos para los que apenas hay datos?
Un estudio publicado en 2024, que recopila 84 trabajos de investigación sobre la IA generativa y los grandes modelos de lenguaje para las lenguas indias, señala la falta de datos, la falta de estandarización, la diversidad lingüística y la insuficiencia de los métodos de evaluación como retos fundamentales.
Julius Haas, ingeniero eléctrico y experto en inteligencia artificial, destaca la desigualdad en la base de datos. En comparación con el inglés o el alemán, el corpus de textos es considerablemente más reducido: "Esto vale tanto para la cantidad como para la calidad", dice Haas, quien vive parcialmente en la India, en entrevista con DW.
Además, agrega, los dialectos locales plantean retos especiales: incluso las diferencias en la ortografía o la entonación pueden ser relevantes.
::: Lenguas en peligro de extinción
En el caso de las lenguas más pequeñas, las limitaciones son aún más evidentes. "Cuando una lengua apenas está documentada y existe muy poco material escrito, no hay datos suficientes con los que entrenar un modelo", explica a DW la sociolingüista Ariba Hidayet Khan, profesora de la Universidad de Kiel. De ahí que la IA solo pueda ayudar de forma limitada a este tipo de lenguas en la actualidad.
La situación es diferente en el caso de las lenguas en peligro de extinción que aún se hablan y de las que existe material disponible. Las ofertas digitales podrían suponer un aliciente para las generaciones más jóvenes para seguir aprendiendo su propia lengua. "Si utilizamos la IA ahora, podría contribuir a preservar la lengua durante más tiempo", cree Khan.
No obstante, si faltan documentación y hablantes, ni siquiera una IA puede revivir una lengua.
::: “Una cuestión de inversión"
Por este motivo, la India está tratando de crear la base de datos necesaria. Un actor importante es AI4Bharat, un instituto de investigación adscrito al Instituto Indio de Tecnología de Madrás. Desarrolla conjuntos de datos y modelos para la traducción, el reconocimiento de voz, la síntesis de voz y los grandes modelos lingüísticos. Sin embargo, los datos disponibles varían considerablemente de un idioma a otro.
"En el fondo, se trata sobre todo de una cuestión de inversión", señala Julian Haas. "Ya no se necesitan avances tecnológicos fundamentales", apunta el experto, y agrega que lo decisivo es a dónde se destinan los fondos de investigación y los recursos para la formación y la infraestructura.
Según el Informe sobre el estado de la educación en la India 2025, de la UNESCO, la lengua está estrechamente vinculada al aprendizaje, la identidad y la pertenencia cultural. Por ello, la UNESCO aboga por tecnologías digitales inclusivas que fomenten la educación multilingüe. La diversidad lingüística debe reflejarse también en el espacio digital.
::: Posibles nuevas jerarquías
Sin embargo, la digitalización también puede crear jerarquías completamente nuevas. Y es que una IA no refleja automáticamente toda la diversidad de una lengua. Si para un modelo se dispone principalmente de datos de una variante concreta ya consolidada, esta puede convertirse en el estándar digital. En este caso, otros dialectos y variantes regionales pueden seguir perdiendo visibilidad.
"Ya hoy en día vemos que la IA funciona mejor, por ejemplo, con el inglés estadounidense que con otras variedades del inglés", afirma Ariba Hidayet Khan. Para la India, esto supone un peligro especial: "La IA podría reforzar las jerarquías lingüísticas existentes", aclara la académica.
A su juicio, la participación de las distintas comunidades lingüísticas en el proceso de recopilación de datos es fundamental. Khan está convencida de que las personas no solo deberían aportar datos, sino también influir en el uso que se les da.
::: Un arma de doble filo
Otro reto es la infraestructura técnica. Cuando los modelos lingüísticos sean lo suficientemente pequeños, podrán ejecutarse directamente en un smartphone u otro dispositivo. Para las regiones con una conexión a Internet débil, esto podría ser decisivo. "Técnicamente es factible", dice Julius Haas.
La IA puede facilitar traducciones, materiales didácticos y nuevas formas de acceder a la información. Pero también puede reproducir o incluso afianzar las diferencias existentes. Y es que la diversidad lingüística en el espacio digital no surge únicamente de la tecnología adecuada, sino también de las decisiones sobre qué datos se recopilan y quién dispone de ellos.